当系统开始改自己:淘宝闪购 RSI 选品 Agent 拆解
本文基于阿里技术 2026 年 10 月 29 日发布的《基于 RSI 架构的淘宝闪购店铺装修选品 Agent 实践》(作者:潘雯静)整理,配图取自原文。原文信息密度很高,我按”问题—机制—验证—反思”重新组织了一遍,并补上了自己的判断。
先看一组数字。
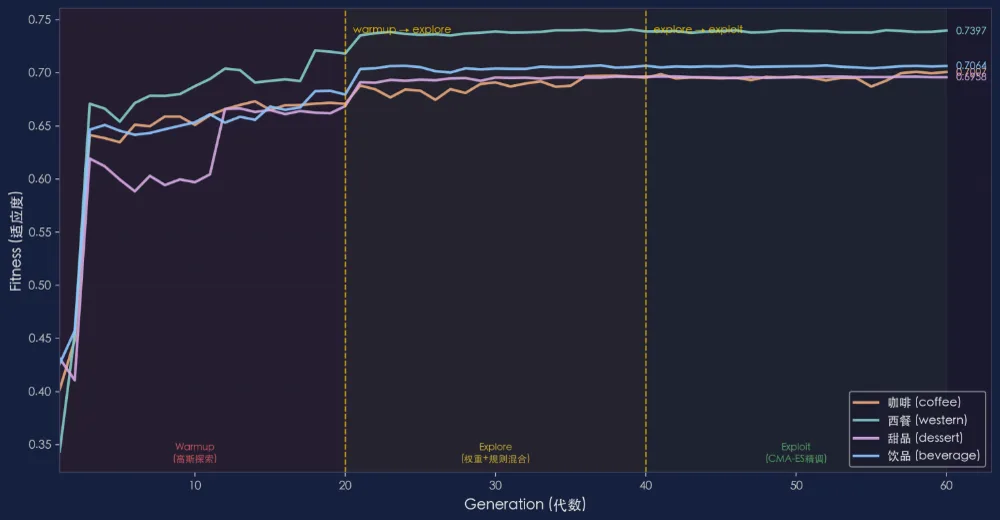
四个品类,每个品类跑 60 代搜索,每岛 1000 家店。咖啡的适应度从 0.4020 爬到 0.7008,西餐从 0.3439 爬到 0.7407。然后把这些候选冻结,拿到线上做了 8 天 AB,覆盖约四万家店,整店加购转化率 P2 相对提升 0.34%,p = 0.0389。
0.34% 在电商语境里不算小数目。但真正值得看的不是这个数字,而是它背后那条链路:一个系统,怎么在没人给它写新规则的前提下,自己找到更好的选法,并且证明这个选法确实更好。
这件事的名字叫 RSI——Recursive Self-Improvement,递归自我改进。
一、先看清楚:要优化的到底是什么
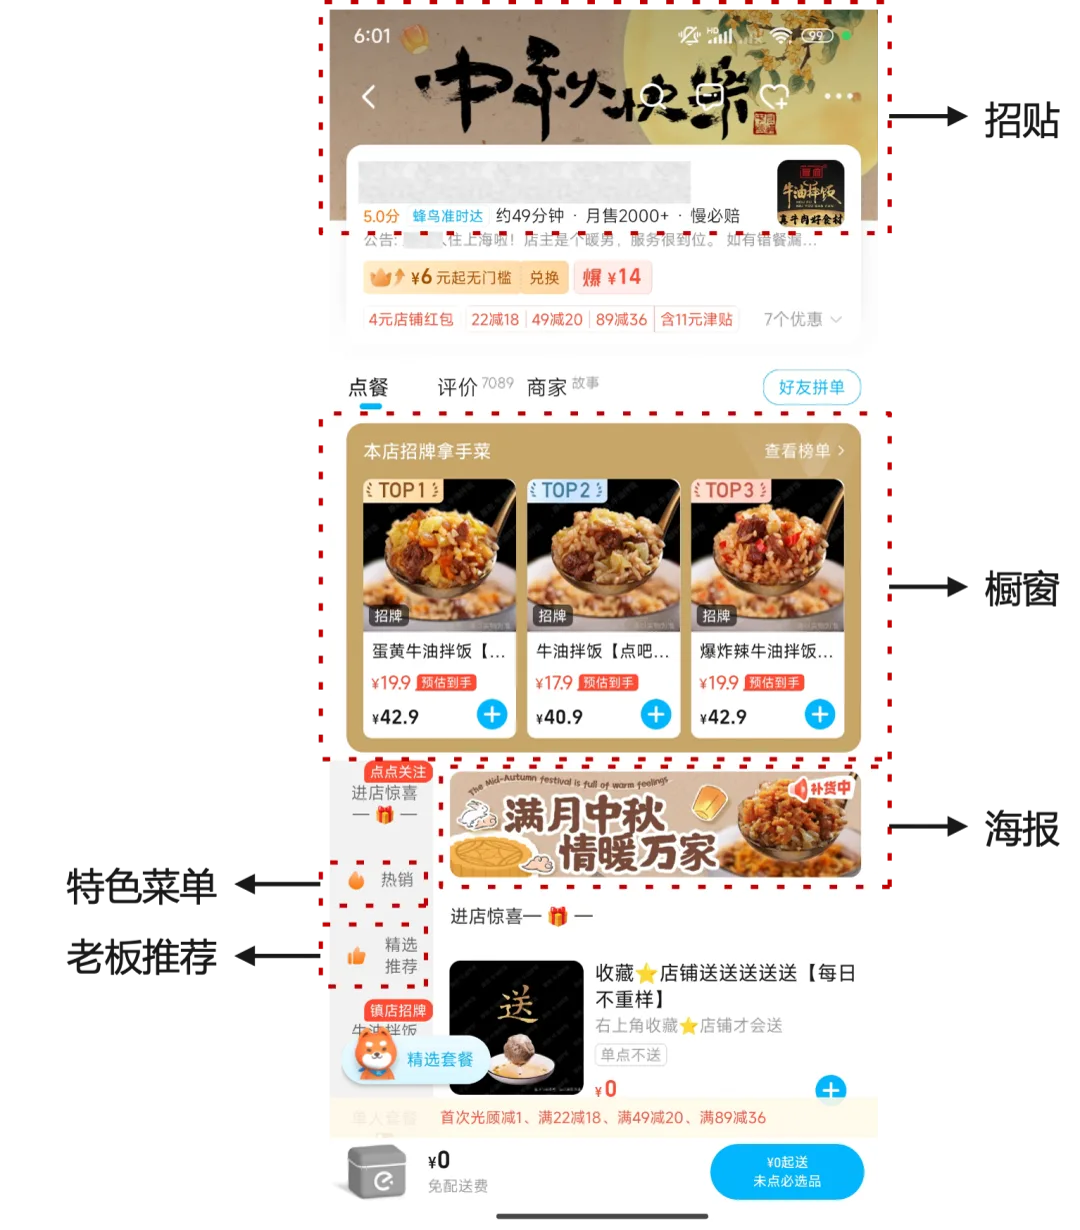
淘宝闪购的店铺装修,商家能配的展示位就那么几块:橱窗、老板推荐(精选推荐)、海报、特型招贴。位置有限,但每个位置”值得放什么”完全不同。
难点在于,这不是四次独立的选品,而是一次联立求解:
- 跨板块互相影响。一款热销咖啡可能适合多个板块,但如果每个位置都反复展示它,其他商品就失去了被看见的机会。单板块的最优列表拼起来,未必是整店的最优组合。
- 环境一直在变。新品、库存、用户偏好都在迁移,策略必须持续产出新候选并重新评价。
- 验证成本有限。线上实验的流量和时间都是稀缺资源,不可能把每个想法都拿去跑 AB。
于是核心问题被压缩成一句话:
怎样持续地、自动化地找到更好的选法,又怎样以可控成本判断它确实更好?
接入搜索之后,团队很快撞上两个很”反直觉”的现象:
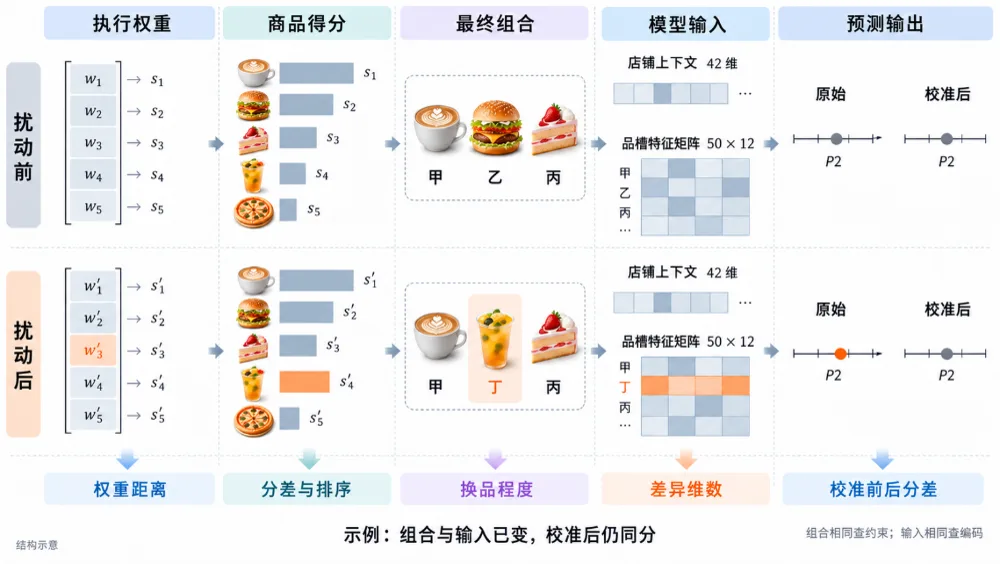
权重在变,橱窗里的商品却没有变;商品换了,模型评分又可能几乎不变。
前者说明参数探索没有形成新的业务决策,后者说明评价环节没提供足够的区分信号。这两个现象后来贯穿了整篇文章——它们不是 bug,而是这类系统的结构性风险。
二、RSI 改进的到底是什么
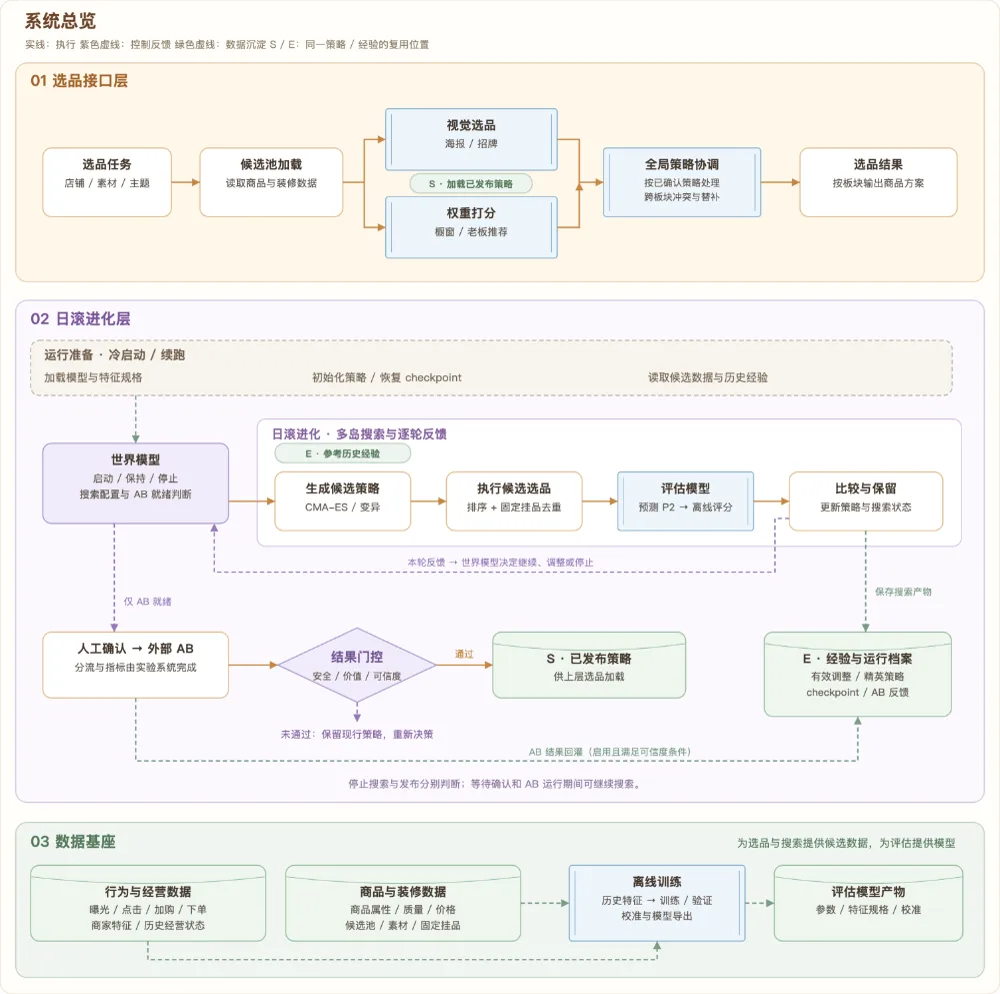
很多人对”自我进化”的想象是:模型自己改自己的代码。这套系统不是。它的”自我”,指的是承担选品决策与策略搜索的这个系统本身,可调的东西分两层:
| 层级 | 具体对象 |
|---|---|
| 第一层:选品策略 | 橱窗与精选推荐的权重、允许调整的组合规则 |
| 第二层:搜索状态 | 采样分布、精英档案、步长、算子配比、经验偏置 |
第二层容易被忽略,但它才是”递归”的关键:系统不仅在改策略,还在改”自己找策略的方式”。
原文给了一个很硬的判断标准,我觉得值得抄下来:
仅反复调用模型、记录结果或随库存重算商品,都不足以证明递归改进;需要追踪哪些反馈改变了后续决策,并检验这种改变是否有效。
也就是说,”接了大模型”不算 RSI,”每天都跑一遍”也不算。只有当你能指出”因为第 N 轮的某个反馈,第 N+1 轮的候选生成方式变了”,递归才成立。
Agent Loop:把”进化”拆成六个动作
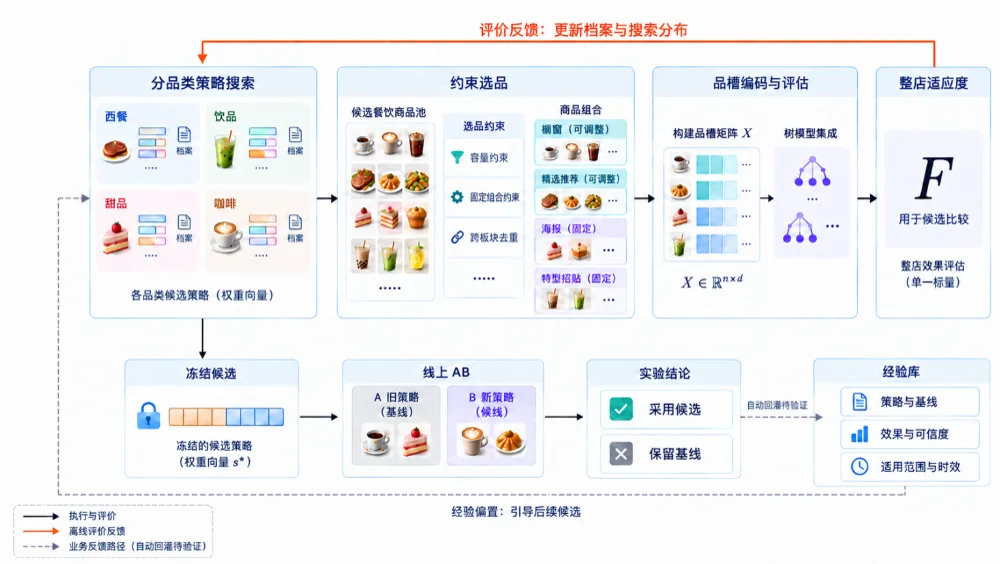
这套系统用 Agent Loop 来组织每一轮进化,六个环节各司其职:
| 环节 | 做什么 | 解决什么 |
|---|---|---|
| 观察 | 读当前数据窗口、基线策略、候选档案、评分趋势与历史经验 | 我从哪开始、已经试过什么 |
| 决策 | 选父代、变异算子、搜索步长、允许调整的参数 | 在预算内提出值得比较的候选 |
| 执行 | 把候选策略套进选品器,落实容量、固定挂品、去重约束 | 把参数变成真正可执行的商品组合 |
| 评价 | 构造品槽特征,在同一模型与数据口径下算适应度 | 给候选之间提供可比较的反馈 |
| 更新 | 更新精英档案、搜索分布、调度状态、经验记录 | 让这一轮影响下一轮 |
| 业务验证 | 冻结候选、上线 AB、核对发布版本与效果 | 检验离线候选是否带来真实 P2 收益 |
最后一行原文标注得很诚实:自动闭环仍待联调。也就是说,从”线上效果”回到”下一轮搜索”的那条虚线,目前还是人工接的。
三、分岛:为什么不能把所有品类塞进一个搜索
系统借鉴了 Shinka 的候选管理与分岛搜索思想,但把”修改程序”换成了”调整策略参数”。分岛是其中最工程化、也最容易被低估的一招。
四个品类——咖啡、西餐、甜品、饮品——各自开一个岛,每个岛独立维护:当前策略、历史最优、候选档案、橱窗与推荐的搜索分布、停滞状态、步长、经验。
为什么要分开?因为一个咖啡店的”图片质量权重”和一个西餐店的”上架时效权重”根本不在一个语义空间里。原文有一句很关键的话:跨岛分数不能直接作为优劣排名。
岛内靠精英档案收敛,每岛容量 20 个。入档不是”分高就进”,而是要求高于档案末位,并且配对改进的置信区间下界大于 0——换句话说,得证明这不是运气。
岛与岛之间还有迁移,用环形连接加跨环桥接,但迁移是有门槛的:
- 相似度高 → 加权融合。目标岛中显著高于同板块均值(均值 + 2 倍标准差)的维度会被保护起来,避免融合把本岛的强项冲淡;融合后必须回目标岛重新评价,置信区间下界高于目标岛档案中位数才尝试入档。
- 相似度中等 → 不搬策略,只小幅提高探索强度。
- 相似度过低 → 直接拒绝。
这套规则读起来有点啰嗦,但它解决的是一个真实矛盾:借经验可以加速,但借错了会污染整个岛。
四、连续权重 → 离散商品:一条容易被忽略的等价关系
这是全文我认为最漂亮的一段。
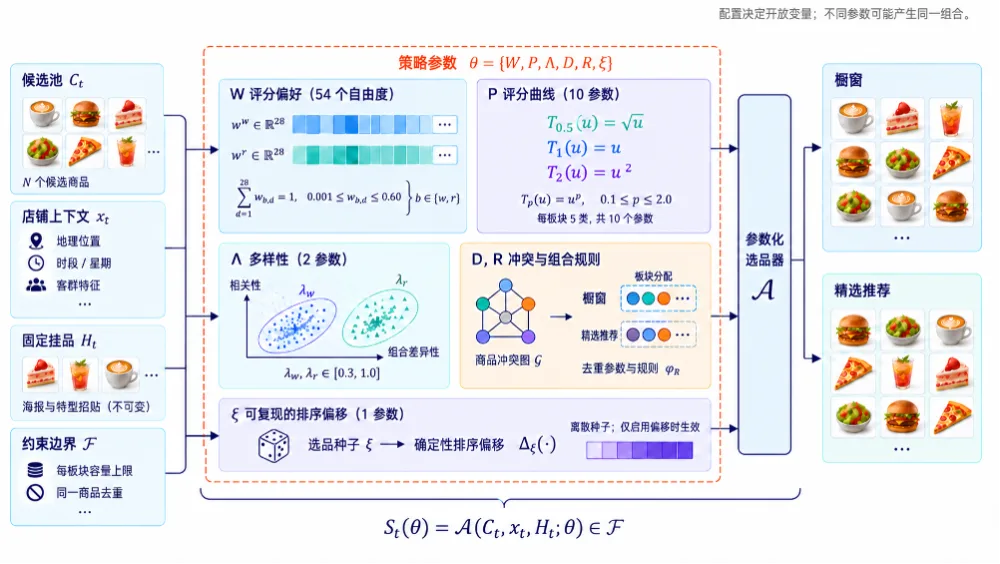
策略搜索调的是连续权重,最终要的却是”这 8 件商品放橱窗”这种离散结果。两者之间不是一一映射——不同的参数,可能产生完全相同的商品组合。
原文用一个咖啡店的极小案例把这件事讲透了。
假设橱窗和精选推荐各展示一件,海报固定展示”经典拿铁”,禁止跨板块重复;只保留”热销””新品”两个特征。两款商品:
- 美式咖啡 = (0.90, 0.20)
- 柚香拿铁 = (0.50, 0.70)
橱窗权重从 (0.60, 0.40) 改成 (0.40, 0.60):
- 美式得分:0.62 → 0.48
- 柚香拿铁:0.58 → 0.62
橱窗于是从美式换成了柚香拿铁。而精选推荐原本的排序是”柚香拿铁 → 燕麦拿铁 → 美式咖啡”,因为柚香拿铁被橱窗选走,推荐顺延选了燕麦拿铁。
于是得到两个截然不同的策略:
- 策略 A:橱窗 = 美式,推荐 = 柚香拿铁
- 策略 B:橱窗 = 柚香拿铁,推荐 = 燕麦拿铁
海报始终不变。注意这里的微妙之处:橱窗只换了一款商品,但推荐也跟着变了。这就是”联立求解”的真实含义。
离散组合搜索的两个任务
定义清楚等价关系之后,搜索被拆成两个先后任务:
- 先越过选品边界,让参数变化真正产生一个不同的可行组合;
- 再判断新组合是不是更好。
很多搜索系统只做第二件事,然后困惑于”为什么搜了半天没变化”。因为大部分参数扰动都落在”评分平台区”里——分数动了,排序没动,组合没动。原文对这一点的表述很克制:参数变化不一定引起商品变化。
再看搜索空间有多大。仅权重部分就有 54 个数值,扣掉两个板块各一个归一化约束,独立自由度 52;如果同时开放 10 个幂指数和 2 个 MMR 系数,有 66 个连续自由度。若 54 个独立坐标各试 10 档,网格组合数量级约 10^54。
所以这不是”能不能算”的问题,是”根本不可能穷举”的问题。
CMA-ES:一个完全不懂业务的调参者,怎么变聪明
这里需要解释一下 CMA-ES,因为它听着吓人,其实是一个很朴素的直觉。
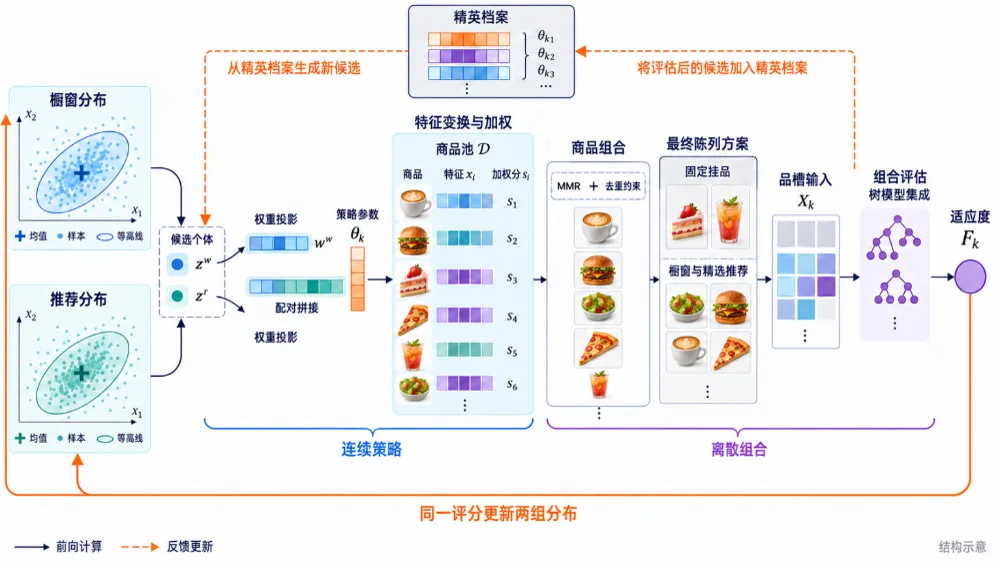
想象你在一个漆黑的房间里找最低的那块地板。你看不见地面,只能迈一步、报一个高度,然后继续。 一个人的话,很快会绕圈。CMA-ES 的做法是撒一群人(种群)进去:
- 让每个人各迈一步,收集所有人的高度;
- 统计”走得好的那几个人,大致朝哪个方向、迈了多大步”;
- 下一批人往这个方向聚拢,但保留一点随机性,防止全体掉进同一个小坑;
- 反复几轮,人群会自己收拢到低处。
关键在于:它维护的不是一个最优答案,而是下一次该往哪儿撒人的概率分布——均值代表方向,协方差代表撒开的形状。所以它天然适合”参数连续、反馈不可微、好坏只能打分”的场景,而这正是选品策略的形态。
这套实现用的是 sep-CMA-ES(对角协方差),在权重的对数比值空间采样,经 softmax 变成权重,再做有界投影限幅。目前单次搜索预算是 60 代。对角协方差的代价是学不到维度之间的相关性——这个限制在后面会以”跨板块联合反馈”的形式再次出现。
五、评估器:如果模型分不清两种选法,搜索就是在盲走
有了候选,还得有人给分。这一步如果不可靠,前面所有精巧都会变成放大器——搜索会反复保留”评估器认为更好”的候选,把微小偏差放大成系统性错误。
原文的一句话我很喜欢:
能够区分两家店,并不保证能区分这两种选法。
评估器迭代了三代,每一代都在解决上一代的”看不见”:
| 代次 | 结构 | 暴露的问题 |
|---|---|---|
| 第一代 | 基线回归 + 残差回归 | 聚合特征削弱了少量换品的差异,出现”商品变了、评分几乎不变” |
| 第二代 | Slot Model:按板块展开单品特征 | 换品能直接改变输入片段,但标签分布不均,密集区间区分不足 |
| 第三代 | Slot Expert:门控 + 通用回归 + 稠密域专家 | 用专家学局部差异,再逆变换回统一尺度 |
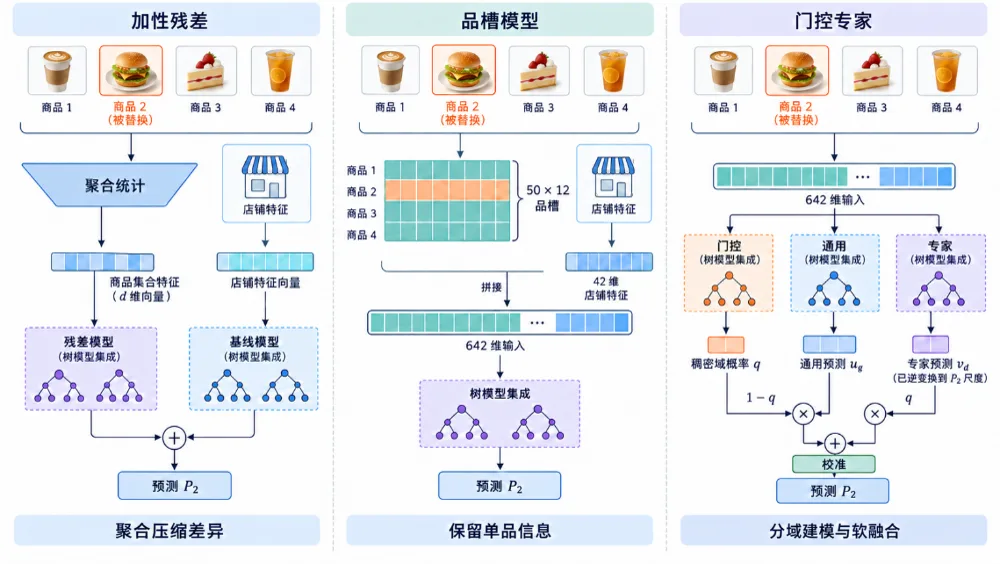
输入是 642 维:50 个品槽 × 12 个商品特征 + 42 维店铺特征(橱窗 10 槽、精选推荐 20 槽、海报 10 槽、特型招贴 10 槽)。12 个商品特征包括近周/近月销量、曝光、点击、加购、近月净成交额、店内销量排名、图片清晰度与完整性等。
门控专家:一个”分工 + 仲裁”的结构
这里的设计思路其实和公司里分工很像。
P2 的样本分布很不均匀,大部分订单集中在某个区间(稠密域)。用一个模型覆盖全域,结果就是”在稠密域里区分不够细”。于是拆成三块:
- 通用回归器:负责整体趋势;
- 稠密域专家:只学密集区间里的细微差异,训练时用标签拉伸把局部差异放大,输出后再逆变换回统一尺度;
- 门控网络:预测这条样本落在稠密域的概率 q,据此决定两者融合的比例。
软融合而非硬切换,是为了避免边界处预测值跳变。原文对门控的边界说得很清醒:
门控不能凭空制造有效信息。
也就是说,如果专家本身没学到东西,门控只是把噪声按比例混进来。
训练目标是 均方误差 + RankNet 组内排序的联合目标,候选组围绕同一原始店铺日组织,含原样本、板块内顺序增强、商品扰动样本。这里有个诚实的注脚:商品扰动产生的比较标签来自历史指标构造的代理信号,不等于真实反事实收益。
效果上,Slot Model → Slot Expert 让留存测试 R² 从 0.0707 提升到 0.2341,MAE 从 0.1298 降到 0.1166。自动调参八轮把候选排序准确率从 69.82% 推到 70.40%。
六、受限调度:让系统决定”怎么搜”,但只在允许的格子里
这是我个人认为最有借鉴价值的一块,它回答了一个很实际的问题:大模型该放在流程的哪个位置?
答案不是”让大模型决定选什么”,而是”让大模型决定怎么搜”——而且它的权限被卡得很死。
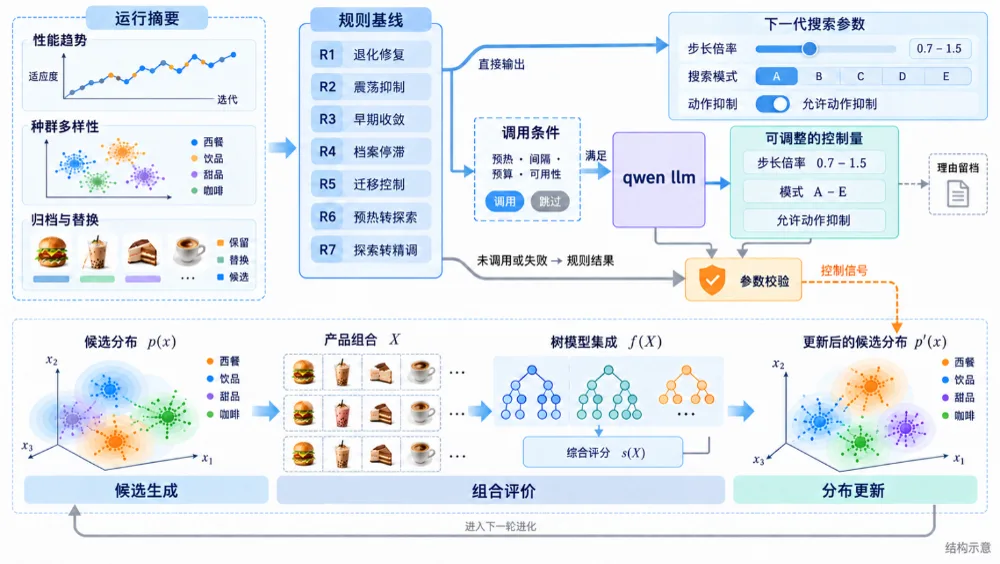
原文的做法是:规则先给出可执行基线(R1–R7),大模型(qwen)在满足调用条件时提出受限调整,经参数范围与动作权限校验后生效;未调用或调用失败时,沿用规则方案。
| 规则 | 主要观测 | 动作意图 |
|---|---|---|
| R1 退化修复 | 距峰值差距、短期下降、持续代数 | 重启分布并扩大探索 |
| R2 震荡抑制 | 较大波动、趋势平坦、档案差异小 | 收缩步长、提高定向搜索 |
| R3 早期收敛 | 收敛跟踪器已确认、未进入精调 | 提前进入精调 |
| R4 档案停滞 | 多代无优选更替、无新候选命中 | 清理低效档案、强制探索 |
| R5 迁移控制 | 岛间排名、收敛状态、迁移接受 | 请求迁移或保护本岛 |
| R6 预热转探索 | 代数、趋势、档案填充 | 切到探索阶段配置 |
| R7 探索转精调 | 代数、趋势、档案离散度 | 收缩到精调阶段配置 |
大模型只能输出结构化参数:步长倍率(0.7–1.5)、预定义算子模式、可抑制的动作。除此之外不能碰。
我觉得这个设计真正解决的是成本与可靠性两个问题:
普通候选的打分与评估不需要等待大模型,使模型调用成本与候选评价次数解耦。
上千次候选评价里,可能只有几次需要”改变搜索方式”的判断。把大模型放在这个稀疏位置上,既省钱,也避免了”模型抽风导致整轮搜索跑偏”。
另外,原文特意区分了三个不同的判断:停止搜索、建议实验、批准发布。它们由不同证据支撑,不能合并成一个”要不要继续”的按钮。这个区分看起来很细,但工程上非常必要——停止搜索是成本判断,建议实验是收益判断,批准发布是风险判断。
七、经验:这一轮学到的东西,下一轮还在不在
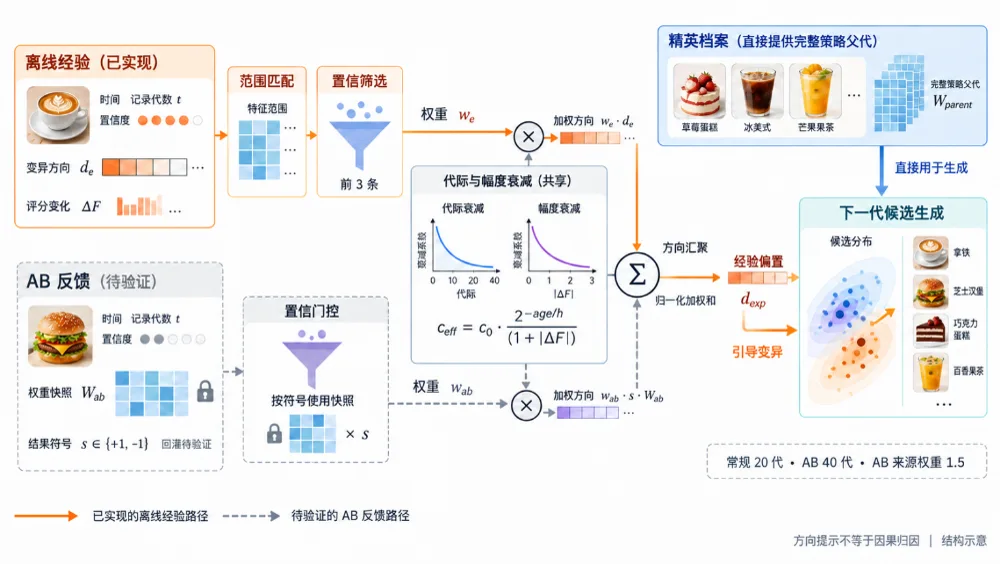
这是 RSI 里最微妙的环节。系统会攒经验,但经验有两种来源,性质完全不同:
| 来源 | 优点 | 缺点 |
|---|---|---|
| 离线评估经验 | 反馈密集,能指导探索 | 继承评估器自身的偏差 |
| 真实 AB 经验 | 业务证据直接 | 反馈滞后、覆盖有限 |
处理办法是代际与幅度双因子衰减:置信度 = 基础置信 × 2^(-代数/半衰期) / (1 + |ΔF|)。常规经验半衰期 20 代,AB 经验 40 代,AB 条目还额外给 1.5 倍来源权重。存量上限也不大:岛级 50 条、店级 20 条。
经验不是一段文字,而是结构化方向——“板块 → 特征 → 调整量”。这些方向按置信度加权汇聚成探索偏置,普通权重方向过滤低置信后只取最高的 3 条。
原文在这里加了一个很重要的刹车:
AB 经验保留的是被实验策略权重快照,并不自动计算”实验组减对照组”差值,不能直接解释为已完成因果归因的有效改动方向。
这句话的意思是:系统知道”这个方案在 AB 里赢了”,但不知道”赢在哪个权重上”。它只是把这个快照当方向参考,而不是当因果结论。
八、适应度:0.4 涨到 0.6,到底意味着什么
这一节容易被跳过,但它是防止自欺的关键。
适应度先对当天有效店铺平均,再对日期平均;跨日期时引入同日基线做差分。
原文有一句必须划重点的警告:
fitness 从 0.4 增长到 0.6,不能解释为真实 P2 增长 20 个百分点。
因为适应度是模型预测出来的相对量,它跟真实业务指标之间隔着评估器本身。系统同时记录三个东西:fitness、预测 P2、线上 AB 效应——三者分开记,不许混着说。
适应度里还可以叠加多样性项(被选商品品类分布的归一化熵)、退化惩罚、多日聚合。前 20 代质量权重 0.80,之后 0.85——前期更看重探索。
橱窗和推荐分别维护 CMA-ES 状态,但同一次采样会把两个板块的权重拼成一个完整策略,整店评估后用同一个适应度同时更新两个板块的分布。局限也很清楚:没有显式估计单个板块的边际贡献,也没有学习跨板块的完整协方差。
九、反馈失效诊断:信号是在哪一层消失的
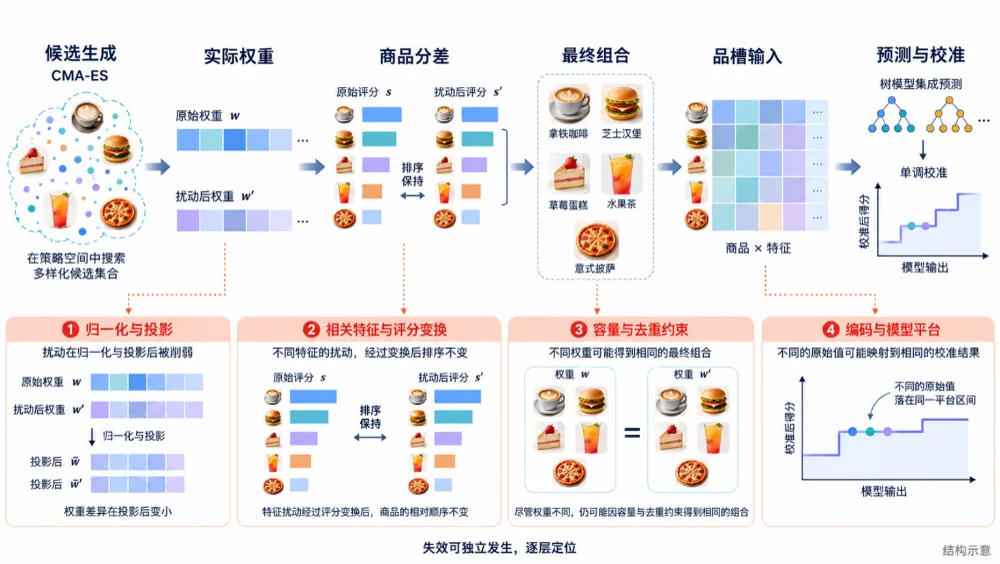
既然”参数变了、商品没变””商品变了、分数没变”是常态,系统配了一套五层排查。这部分我觉得可以直接搬到自己项目里用。
诊断目标不是”提高换品率”,而是确认状态更新—行为变化—评价差异这条链是否成立。原文说得很明白:重复组合与同分率是诊断指标,提高换品率本身并非改进目标。
五层依次往下问:
- 参数真的变了吗? 比较真正进入选品器的权重——归一化、投影之后可能已经很接近。
- 变化传到商品得分了吗? 高度相关的信号可能给所有热门品同样的优势;要看商品得分间隔,而不是权重距离。
- 新排序产生新组合了吗? 候选池接近容量、固定商品占位多、去重约束强,都会让不同排序落回同一个组合。
- 模型实际看到新商品了吗? 商品 ID 变了不代表 642 维输入一定变,要逐维比较特征。
- 预测差异在哪里消失? 分别检查原始预测与校准后预测,树模型分段加单调校准容易形成平台。
咖啡店案例在这里又被用来做反例:如果权重确实不同、橱窗却还是美式,就查评分排序和固定挂品约束;如果已经变成”柚香拿铁 + 燕麦拿铁”,就查品槽有没有同步变化;如果原始预测不同但校准后都落在 0.300,那差异就消失在校准环节。
早期有一次诊断实验的结果很能说明问题:修复调整幅度与评分问题后,测试中选品变化度从 0 提升到 0.61,选品不变的店铺占比从 55% 降到 0%。
(原文特意标注:这是机制指标,不是业务收益,不能和其他定义的换品指标合并。)
十、验证:离线对照与线上 AB
离线对照:多岛跑起来长什么样
四品类各执行 60 代,每岛 1000 家店,LLM 调度模式:
| 品类 | 初始适应度 | 历史最高 | 峰值代数 |
|---|---|---|---|
| 西餐 | 0.3439 | 0.7407 | 39 |
| 饮品 | 0.4262 | 0.7069 | 52 |
| 咖啡 | 0.4020 | 0.7008 | 58 |
| 甜品 | 0.4313 | 0.6965 | 42 |
顺带能看到一些很”业务”的结论,比如咖啡橱窗更看重”图片非翻拍”和”上架时效”,而甜品橱窗的城市热销权重达到 0.60。
CMA-ES vs 随机搜索:同预算下的公平对照
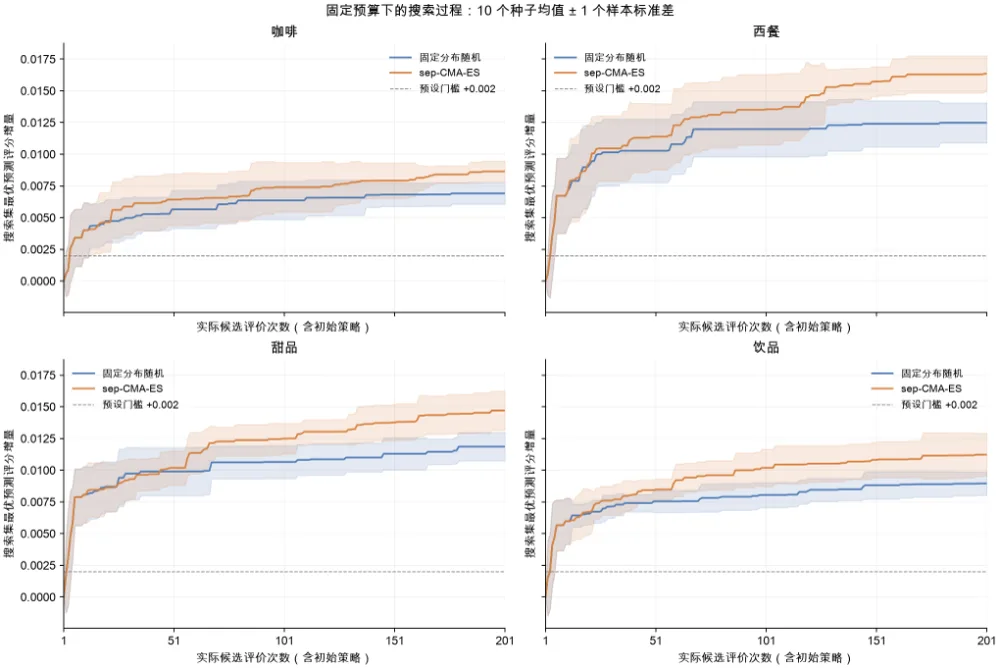
设计是四品类 × 10 个配对种子 × 每方法每品类 201 次候选评价 = 16,080 次搜索评价;1,999 家店中 1,599 家参与搜索、400 家留出。
等权配对后:随机组留出增量 +0.010593,CMA 组 +0.014150,差值 +0.003557,95% 区间 [+0.002089, +0.005234]。饮品的区间跨过了 0,也就是说在这个品类上还不能断定 CMA 更好。
有个细节很有意思:以”初始评分 +0.002”为达标门槛,达到门槛所需的评价次数均值是随机组 5.300、CMA 组 6.275;40 组配对里有 37 组在共同首批候选内就已达标——那时候 CMA 还没来得及利用反馈。
这说明 CMA-ES 的优势不在”开局更快”,而在”持续利用反馈后走得更远”。 这也恰好呼应了全文的主题:反馈能不能被用起来,决定搜索能走多远。
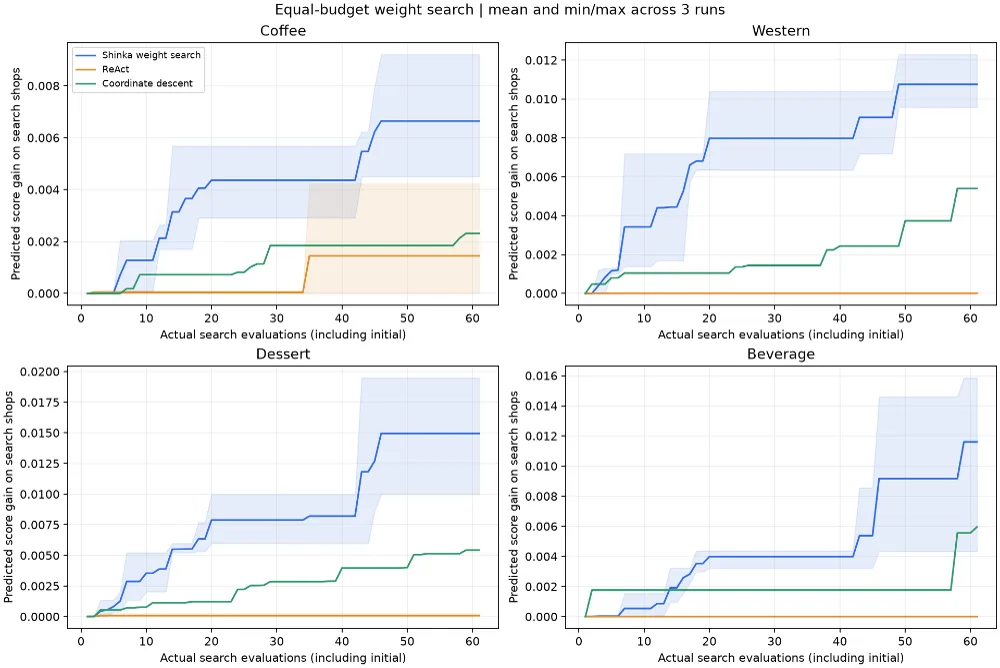
搜索框架的对照也在做,但原文很克制地承认旧结果不可用(坐标下降不能代表完整 AutoResearch、旧评估器特征构造后来被修正、旧缓存缺完整店铺上下文),正式复验尚未完成。
线上 AB:把”更好”变成可检验的命题
AB 实验的逻辑其实很朴素,但朴素正是它的价值。
想象你开两家一模一样的店,同一时间,一家换新做法,一家维持老做法,然后比谁卖得多。 关键在于”一模一样”和”同时”——如果两家店本来客流就不同,或者换做法的时间点赶上大促,你比的就不是做法,而是运气。所以 AB 的价值不在”跑了实验”,而在把干扰项摁住。
这次实验:控制组是已有托管策略,实验组是进化筛选出的候选策略,按 C 端用户随机分组并保持稳定,两组策略冻结;主指标是进店至加购的整店 P2,并考虑同一用户重复访问。
结果:首轮覆盖四个类目、约四万家店,按用户 50:50 分流,8 天有效观测中整店 P2 相对提升 0.34%(p = 0.0389);辅助指标 访问下单率 +0.46%(p=0.0284)、进店下单转化率 +0.44%(p=0.0347)。
原文同时标注了局限:不能据此认定长期收益,也无法拆出各机制的独立贡献。
十一、我的三点思考
前面都是别人的系统。下面是我读完之后的判断。
一、RSI 的价值,最终取决于反馈能否把”下一轮”推到不同的地方
这句话几乎是全文的题眼,也是我认为最难做到的部分。
大多数团队做”自进化”的路径是这样的:先把链路跑通,指标能算出来,日志能存下来,然后……就停在这里了。数据在库里,但没有被任何生成器消费。原文有一句话很扎心:
若反馈只被归档而未被后续生成器使用,业务记录尚未闭合为递归改进。
所以我给自己定一个更硬的验收标准:不问”系统有没有记录反馈”,而问”能不能指出某条反馈改变了第 N+1 轮的具体生成行为”。 如果指不出来,那就还是自动化,不是 RSI。
这也是这套系统最值得学的地方——它的每一层都在防”自欺”:适应度不许解释成业务收益,AB 快照不许解释成因果结论,机制指标不许和业务指标合并口径。这些”不许”看着繁琐,实际上是让”改进”这两个字保持可验证性的唯一办法。
二、持续继承经验,还是每轮重新开始?这仍是个开放问题
这套系统选择了继承:精英档案、经验偏置、跨岛迁移、AB 权重快照,都在把上一轮的东西递给下一轮。理由很实际——重新开始太贵,60 代的预算经不起每轮从零。
但继承是有代价的,而且代价很隐蔽:你会继承评估器的偏差,并且通过搜索把它放大。 搜索越勤奋,偏差被强化的速度越快。原文用双因子衰减、20/40 代半衰期、置信度门控、范围匹配来对冲,本质是在赌”旧经验还会继续成立”。
我的看法是:经验应该继承”方向”,而不是继承”结论”。
- 继承方向——“甜品橱窗该更看重城市热销”,这类结构性洞察跨时间稳定;
- 不继承结论——“某个权重取 0.37 更好”,这类具体坐标高度依赖当时的商品池和评估器版本。
原文的做法其实也在往这个方向靠:经验存的是”板块→特征→调整量”的方向,而不是某个权重的绝对值;AB 经验只保留快照、不做因果归因。
但”什么时候该忘”依然没有答案。半衰期是个超参数,20 代还是 40 代,本质上是在猜环境变化的速度。持续继承是否真的优于每轮重新开始,取决于环境漂移有多快——而这件事本身,往往就是最难测的。 我认为这会长期是这类系统的核心待答问题。
三、三句话,可以当 checklist 用
原文最后那句总结,我读了好几遍,觉得它其实是三条工程纪律:
让每一次更新有对象、每一条反馈有去向、每一项收益有独立验证。
把它拆开,就是三个能直接落地的问题:
- 每一次更新有对象——这轮改的到底是策略、搜索状态,还是评估器?版本能不能追溯?说不清”改了什么”,就说不清”为什么变好”。
- 每一条反馈有去向——这条 AB 结论,最终改动了哪个参数、哪条经验、哪次调度?如果它只是躺在报表里,那它对系统等于不存在。
- 每一项收益有独立验证——收益是模型预测的、机制指标带来的,还是 AB 证明的?三者的证据强度天差地别,绝不能混着报。
这三条不只适用于 RSI。任何”带反馈闭环”的系统——推荐、风控、投放、甚至个人的工作复盘——都可以拿它照一照。大部分所谓”闭环”,断在第二条上。
写在最后
读完全文,我最强的感受不是”这套系统好复杂”,而是它把”不确定”处理得很诚实。
它承认 CMA 在饮品上没跑出显著优势,承认自动边界因为排序提升没到 0.5 个百分点而没被采用,承认旧评估器的对照结果不可用、需要复验,承认从线上效果回到下一轮搜索的那条线还是虚线。
一个系统敢把自己的失败指标一起写出来,通常说明它真的在追求”更好”,而不是”看起来更好”。
至于 RSI 会不会成为下一代系统的标配,我不确定。但我比较确定另一件事:未来拉开差距的,可能不是谁的模型更强,而是谁的反馈链路更短、更可信。 因为模型能力是公共的,而”知道自己的改动到底有没有用”,是私有的。
原文:《基于 RSI 架构的淘宝闪购店铺装修选品 Agent 实践》,阿里技术,2026-10-29,作者潘雯静。本文为其内容梳理与个人解读,配图取自原文,版权归原作者所有。