Pi Native CRM 复盘——让 Agent 在受控边界下读写真实业务数据
Pi Native CRM 复盘——让 Agent 在受控边界下读写真实业务数据
仓库:ydflow/pi-native-crm · TypeScript
一句话:以真实 CRM 为状态空间的 Agent 原生工作台。
一、背景:Agent 能不能「真的干活」,而不只是「生成回复」
大多数「AI + 业务」的 demo,本质是「让模型生成一段回复」。但真实业务里,价值在于完整的动作:理解上下文、寻找证据、拆解任务、协同调查、调用工具、观察结果,再决定下一步。
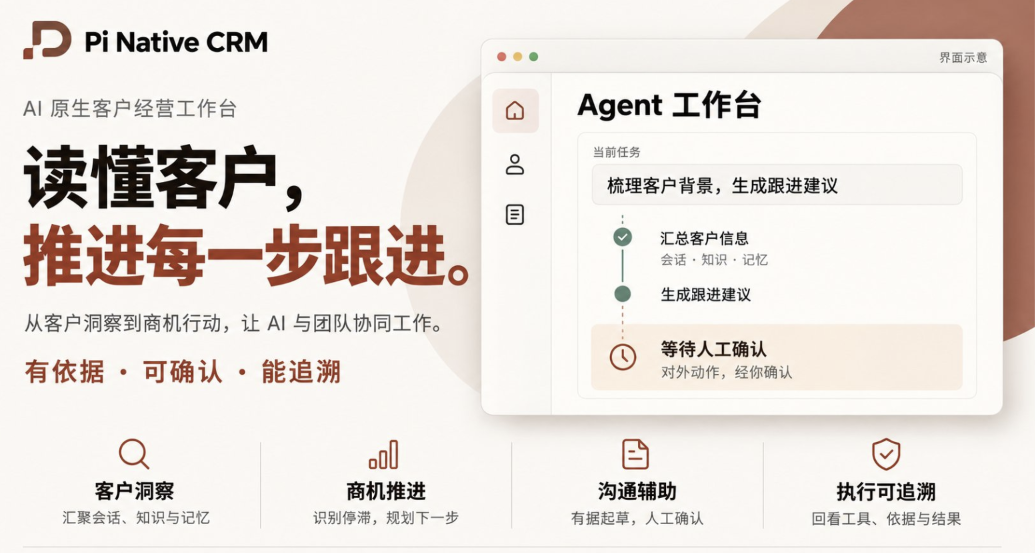
Pi Native CRM 回答的就是这个问题:让 Agent 读取客户与商机,消费知识和记忆,调用工具推进业务;让人看清它做了什么、依据什么,以及 CRM 发生了哪些变化。
一句话概括它的分工:
CRM 保存业务事实,Pi 驱动 Agent 行动,Harness 管理执行边界。
二、核心设计:四个层次
1. Agent 工作台——任务和 CRM 对象为入口
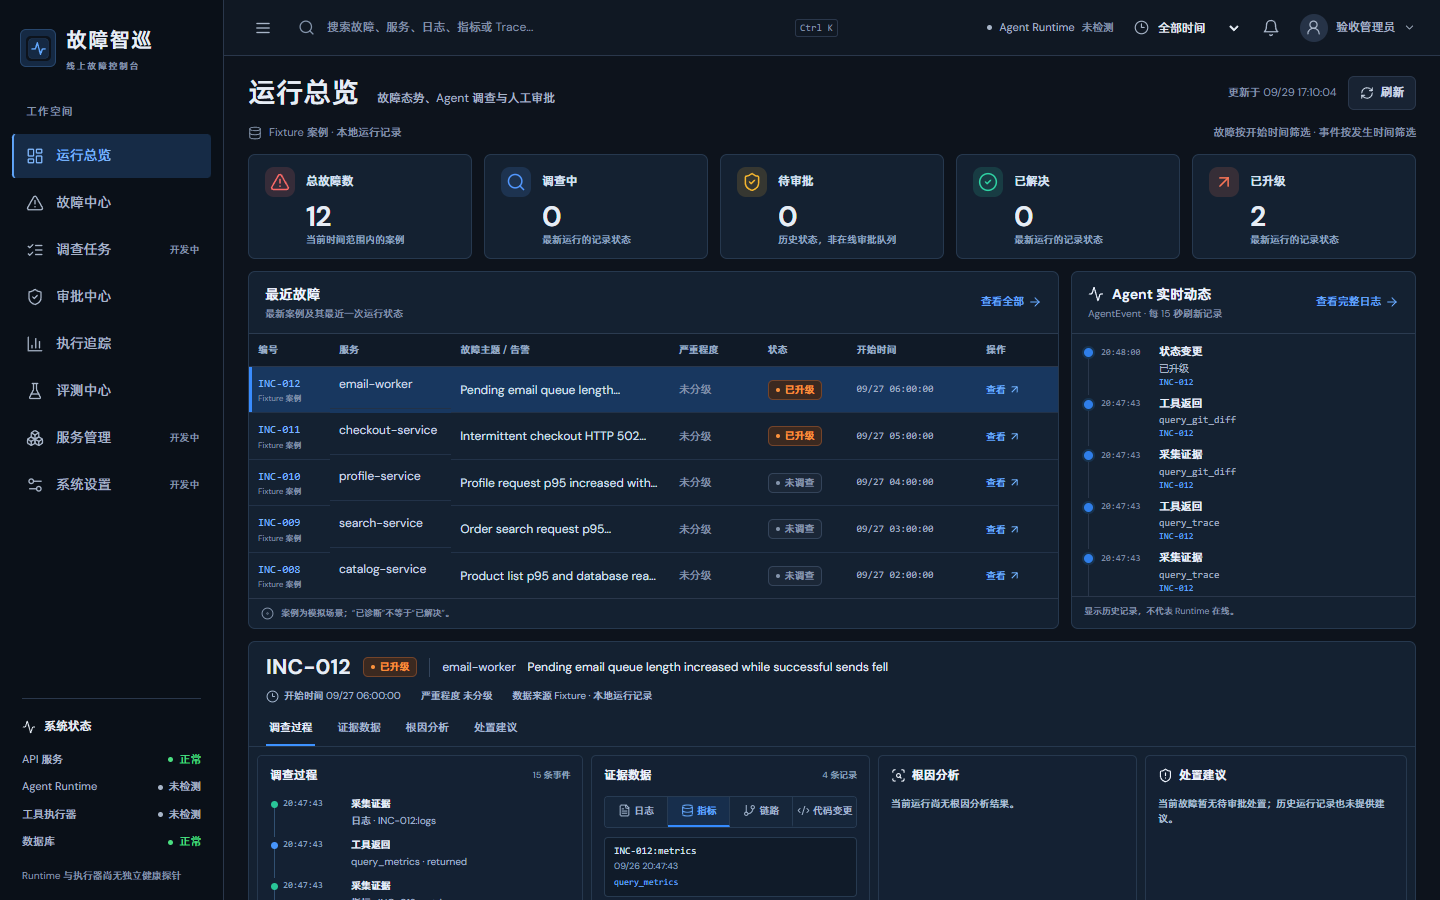
支持只读调查与行动模式,在同一条时间线上看上下文、决策、工具调用、Observation 和状态变化;查看模型绑定、Token 用量、工具次数、预算与终止原因;通过持久化事件和 SSE 续读,刷新后能回放执行过程。
2. 四个内置 Agent,各司其职
| Agent | 职责 |
|---|---|
| CRM 情报员 | 汇总客户、历史会话、商机、知识与记忆,形成带证据的客户画像 |
| 销售运营 Agent | 排查停滞商机、更新字段、调整阶段、安排跟进 |
| 客户沟通 Agent | 结合会话和知识起草回复,核对承诺依据,提出转人工动作 |
| CRM 主管 Agent | 跨漏斗、任务和执行记录调查异常,组织专职 Agent 协作 |
内置原件锁定,通过「复制并定制」创建自己的 Agent——原件跟随组织默认模型,副本固定创建时的模型配置。
3. 受控执行 Harness——这是整个项目的地基
Agent 的 CRM 读写经过工具端口,权限、组织作用域、目标范围贯穿执行。工具按风险分类:
| 类别 | 处理方式 |
|---|---|
| 读取 | 自动执行 |
| 可逆写入 | 有业务补偿能力的,自动执行 |
| 外部动作 | 人工确认 |
| 不可逆动作 | 人工确认 |
保存字段差异、审计记录和撤销动作,支持暂停、恢复、取消、执行租约、重试和累计预算控制。「让 Agent 干活」和「让 Agent 不乱来」在这里被同时解决。
4. 多 Agent 与商机 Mission
主管 Agent 组织只读专职 Agent 调查,用父子 Run 保存各自上下文;独立调查并行执行,父 Run 统一管理业务写入和预算。商机 Mission 保存目标、验收条件、截止时间和跨运行进度。
三、知识与记忆:这是我最关心的部分
作为一个关注 Agent Memory 的人,这个项目的记忆层设计对我意义重大:
- 本地 RAG + WeKnora Wiki:为回答提供知识来源、页面版本与引用;
- 联系人事实经人工确认后进入 CRM 记忆:供后续会话和任务消费;
- Mem0 接入:检索排序、记忆同步、删除与清理回执;
- 分层管理:组织记忆、客户记忆、知识材料、运行历史分层,SQL 保持业务事实源。
记忆不是「存下来就完事」,而是要可靠地写入、召回、更新,并且能追溯到依据。这正是我在简历里反复强调的方向。
四、Eval 与可观测性:反馈如何证明「更好」
评测围绕任务结果、证据、工具可靠性、策略遵守、记忆覆盖展开:
- 结合确定性检查、真实模型语义评审与回归样例,保存评分依据;
- Langfuse 接收模型与工具边界的 Trace、用量和 Eval 分数;
- 持久化投递队列、去重、重试,关联 CRM Run 和外部观测记录;
- 在工作台回看真实模型录制、工具调用及评测结果。
「反馈如何证明下一轮行动确实更好」——这是自进化 Agent 的核心命题,Pi Native CRM 用 Eval 层给了它一个落地的答案。
五、几点复盘
- Harness 是 Agent 产品的生死线。权限、范围、策略、预算、审批、恢复——这套边界做扎实了,Agent 才有资格碰真实数据。
- 记忆的可靠性 = 写入 + 召回 + 更新 + 可追溯。存下来的记忆要能证明「从哪来、经谁确认」,否则就是噪音。
- Eval 要落地到「下一轮是否更好」。Trace 和分数不是摆设,而是要能回放、能复现、能指导改进。
- 内置 + 可定制是 Agent 编排的好范式。锁定原件保证质量,复制定制释放灵活性。
Pi Native CRM 是这 7 个项目里最重的一个,也是和我的求职方向(Agent Memory、评测、自进化)最契合的一个。它把「AI Agent 开发」从一个口号,落成了一套可以审计、可以评测、可以持续改进的系统。