研迹 ResearchTrail 复盘——把「资料」变成「研究」,把「判断」留给时间
研迹 ResearchTrail 复盘——把「资料」变成「研究」,把「判断」留给时间
仓库:ydflow/research-trail · 35 stars · Python 业务内核 · Electron 桌面
一句话:面向个人投资研究者的本地 AI 研究工作台。
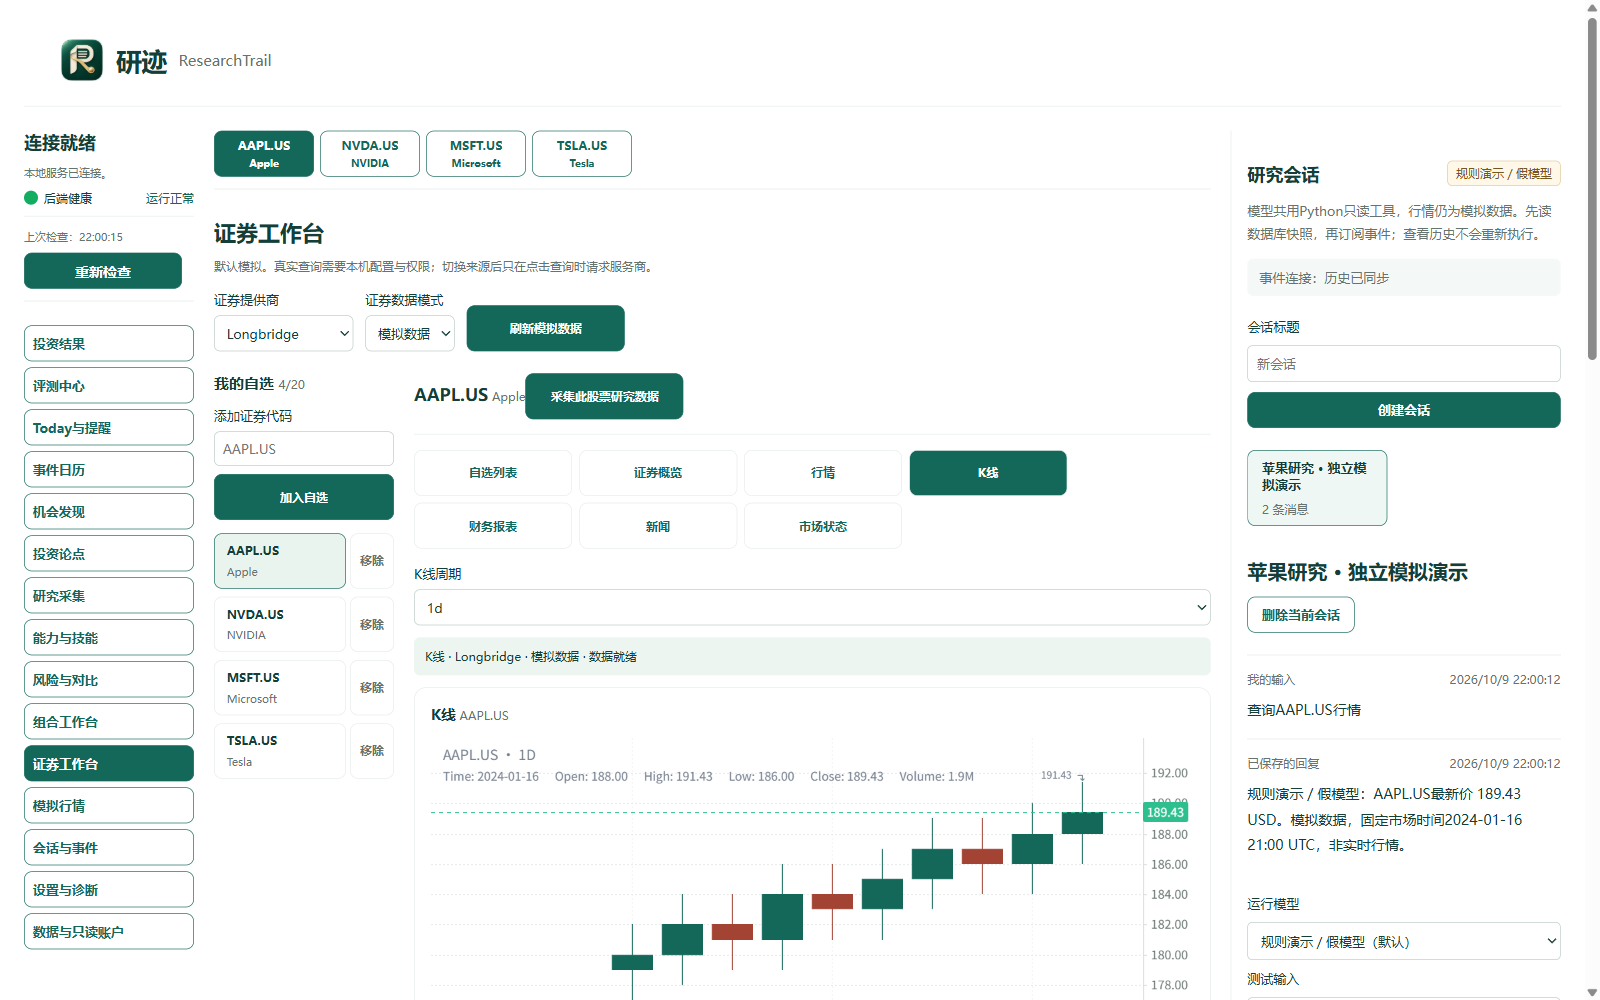
一、背景:三个问题,一个工作区
做个人投研,最痛苦的不是「看不懂」,而是过程无法沉淀。我提炼了三个贯穿始终的问题:
- 当时看到了什么? —— 资料散落,难以回溯。
- 为什么形成这个判断? —— 推理过程没有留痕。
- 后来是否得到验证? —— 判断和结果从未被系统地对照。
ResearchTrail 把这三件事对应到三句设计口号:研究有据、判断留痕、结果分开验证。
二、技术选型:为什么是 Python 内核 + Electron 桌面
这里有一个刻意的取舍。
- Python 业务内核:投研涉及大量的确定性计算(风险指标、标的对比、机会筛选、回放评测),Python 的生态和可读性最适合承载这些「可检查」的逻辑。
- Electron 桌面:本地优先的产品形态,数据留在本地,隐私可控。
两者之间用清晰的边界切开:Electron 负责 UI 和桌面能力,Python 负责业务与采集,「本地持久化」是它们共享的底座。这个分层让「确定性」和「体验」各司其职。
三、核心链路:从一份资料,到一份有依据的研究
1 | 证券 / 组合 / 事件 → Python 采集与冻结资料 → 报告(事实/分析/预测) |
几个关键设计:
1. 报告三层分层:事实 / 分析 / 预测
这是避免 AI 幻觉的又一层防线。报告明确区分「事实」「分析」「预测」:
- 事实可以点回原始执行结果;
- 分析标注立场,没有概率时明确显示「未提供」,绝不从措辞里猜置信度;
- 缺失的数据不会被模型补成事实。
2. 机会筛选:17 个确定性任务,不是「全市场扫描」
机会发现不是让 AI「找牛股」,而是 17 个固定规则任务,在用户选择的有界股票池里扫描,每个候选都携带「为什么入选」的规则与执行事实。这是确定性的,可复现、可审计。
3. 投资论点:保存判断,也保存对判断的检验
论点保留摘要、多空依据、催化因素、风险与版本。编辑会追加记录,复审会比较新旧资料,投资影响由用户显式判断。判断不是写死就完事,而是持续被检验的对象。
四、三类评价体系:各回答各的问题
这是 ResearchTrail 里我最想讲的设计。Agent 产品的「好不好」其实是三个完全不同的维度,混在一起就是一笔糊涂账。
| 评价 | 回答什么 | 怎么做 |
|---|---|---|
| Agent 工程 | 工具选对了吗?运行哪里失败? | 确定性离线案例、断言、工具轨迹、失败分类与回归基线 |
| 研究质量 | 报告忠实于证据吗?分析合理吗? | 同一冻结数据的模型 A/B;八项人工量表,未评审就不显示差值 |
| 投资结果 | 判断后来得到支持了吗? | 冻结时点、评估窗口、后续数据、计算版本,避免未来数据污染 |
投资结果页支持 Brier 分数、分箱校准、技能/策略统计。窗口未到、行情缺失、样本不足时,明确显示原因——宁可说「还不能评」,也不假装能评。
五、结果与边界
质量:1.1.0 内部候选包通过 1171 项离线回归与 20 项安装/升级检查;公开下载仍是 v1.0.0。
诚实的边界(这也是复盘的一部分):
- 首版只在应用运行时调度,关闭期间的计划显示「未执行」,不补跑。
- 二进制许可闭环未确认前,不公开上传新安装包。
- 真实模型验收完成了同源结构和引用校验,但人工质量评分尚未完成。
六、几点复盘
- 「确定性」是 AI 产品的底线。把风险计算、机会筛选、评测做成 Python 确定性逻辑,AI 只负责它擅长的「综合」,不碰它容易出错的「计算」。
- 三类评价必须分开。工程可靠性、内容质量、结果正确性是三个问题,混在一起既没法改进,也没法向用户交代。
- 诚实比好看重要。「未评审就不显示」「窗口未到就说明原因」,这些克制的设计,反而建立起了信任。
- 这是 Trail 的起点。ResearchTrail 验证了「证据链 + 评测」这条路的可行性,才有了后来的 Trail 正式版。下一篇讲 Trail 时,你会看到这两个版本之间真正的跨越在哪。
本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议。转载请注明来源 ydflow的个人博客!
相关推荐
2026-10-12
研迹 Trail 复盘——一个「可检查」的 AI 投研工作台是怎么长出来的
复盘研迹 Trail 正式版:为什么把投资研究做成「本地优先 + 证据链」的桌面工作台,Agent 副驾驶、来源检查器与评测中心分别解决了什么问题,以及一路踩过的坑。
2026-08-10
剪映自动化 Skill 复盘——让 Agent 剪视频,怎么做到「不误删、不伪装、失败可解释」
复盘剪映自动化 Skill 的可靠增强版:基于上游项目二次开源,聚焦「不误删草稿、不伪装格式、版本可判断、失败可解释」,把 Agent 剪视频从能用到可靠。
2026-10-27
Pi Native CRM 复盘——让 Agent 在受控边界下读写真实业务数据
复盘 Pi Native CRM:一个 Agent 原生 CRM 工作台,如何通过受控执行 Harness、四个内置 Agent、知识与记忆层、Eval 与可观测性,让 Agent 可信地读写真实 CRM 数据。
2026-08-28
故障智巡复盘——AI 故障排查,为什么必须「只读取证 + 人工审批」
复盘故障智巡:一个以 Incident 为中心的 AI 线上故障排查平台,为什么「只读取证」和「SAFE/ASK/BLOCK 审批」是设计核心,以及它踩过的边界。
2026-07-22
低配版赛博女友复盘——从一句话到数字人回应,一条链路的搭建与取舍
复盘 16GB 显存数字人项目:用 React + Node.js + Python 串起语音识别、对话生成、语音合成、口型动画,把「一句话」变成「带表情的数字人回应」。
2026-07-05
日序小程序复盘——一个「本地优先」微信日程小程序的架构取舍
复盘日程小程序「日序」:本地优先的数据架构、乐观并发控制、共享清单与共同专注,以及 201 个自动化测试背后的质量思考。